Pourquoi utiliser une IA localement ?
Utiliser un modèle d’IA directement sur son PC, c’est plus qu’une simple posture.
Dans les professions qui manipulent des données sensibles, comme le droit ou la santé, copier un extrait de dossier dans un chatbot hébergé sur un serveur peut exposer des informations couvertes par le secret professionnel. L’installation d’un modèle en local permet de concilier cette exigence avec l’utilisation de l’IA.
Un modèle local ne dépend d’aucune connexion, d’aucun quota d’utilisation ni d’un service distant susceptible de tomber en panne. Il offre aussi une maîtrise dans la durée : les abonnements et leurs conditions peuvent évoluer, tandis qu’un modèle téléchargé continuera de fonctionner tant que la machine est opérationnelle.
Utiliser une IA locale, c’est accepter de perdre légèrement en performance pour gagner énormément en confidentialité et en autonomie.
Les critères qui comptent
Avant de choisir parmi Ollama, LM Studio, Jan ou GPT4All, deux questions permettent d’éliminer la majorité des options : la mémoire disponible et l’usage principal du modèle.
Combien de mémoire possède votre machine ?
La contrainte numéro un est la RAM. Il faut compter environ 0,6 Go de RAM par milliard de paramètres, et ajouter 2 à 3 Go de marge pour le système.
- 8 Go de RAM : environ 3 milliards de paramètres ;
- 16 Go de RAM : 7 à 8 milliards de paramètres ;
- 32 Go de RAM et plus : 13 à 14 milliards de paramètres.
Une carte graphique dédiée peut accélérer le modèle, mais n’est pas obligatoire : sans elle, le calcul se fait sur le processeur.
Quel est l’usage principal ?
Interroger ses documents, rédiger du code ou générer des images sont des usages distincts. Un modèle excellent en code n’est pas forcément le plus agréable pour rédiger un e-mail.
Le choix de l’interface
L’interface charge le modèle d’IA en mémoire, fournit le moyen d’interagir avec lui et exécute le calcul. Sans interface, le modèle n’est qu’un fichier.
Le modèle est le moteur ; l’interface est la voiture construite autour. Le choix dépend donc de la facilité d’usage et de l’écosystème recherché.
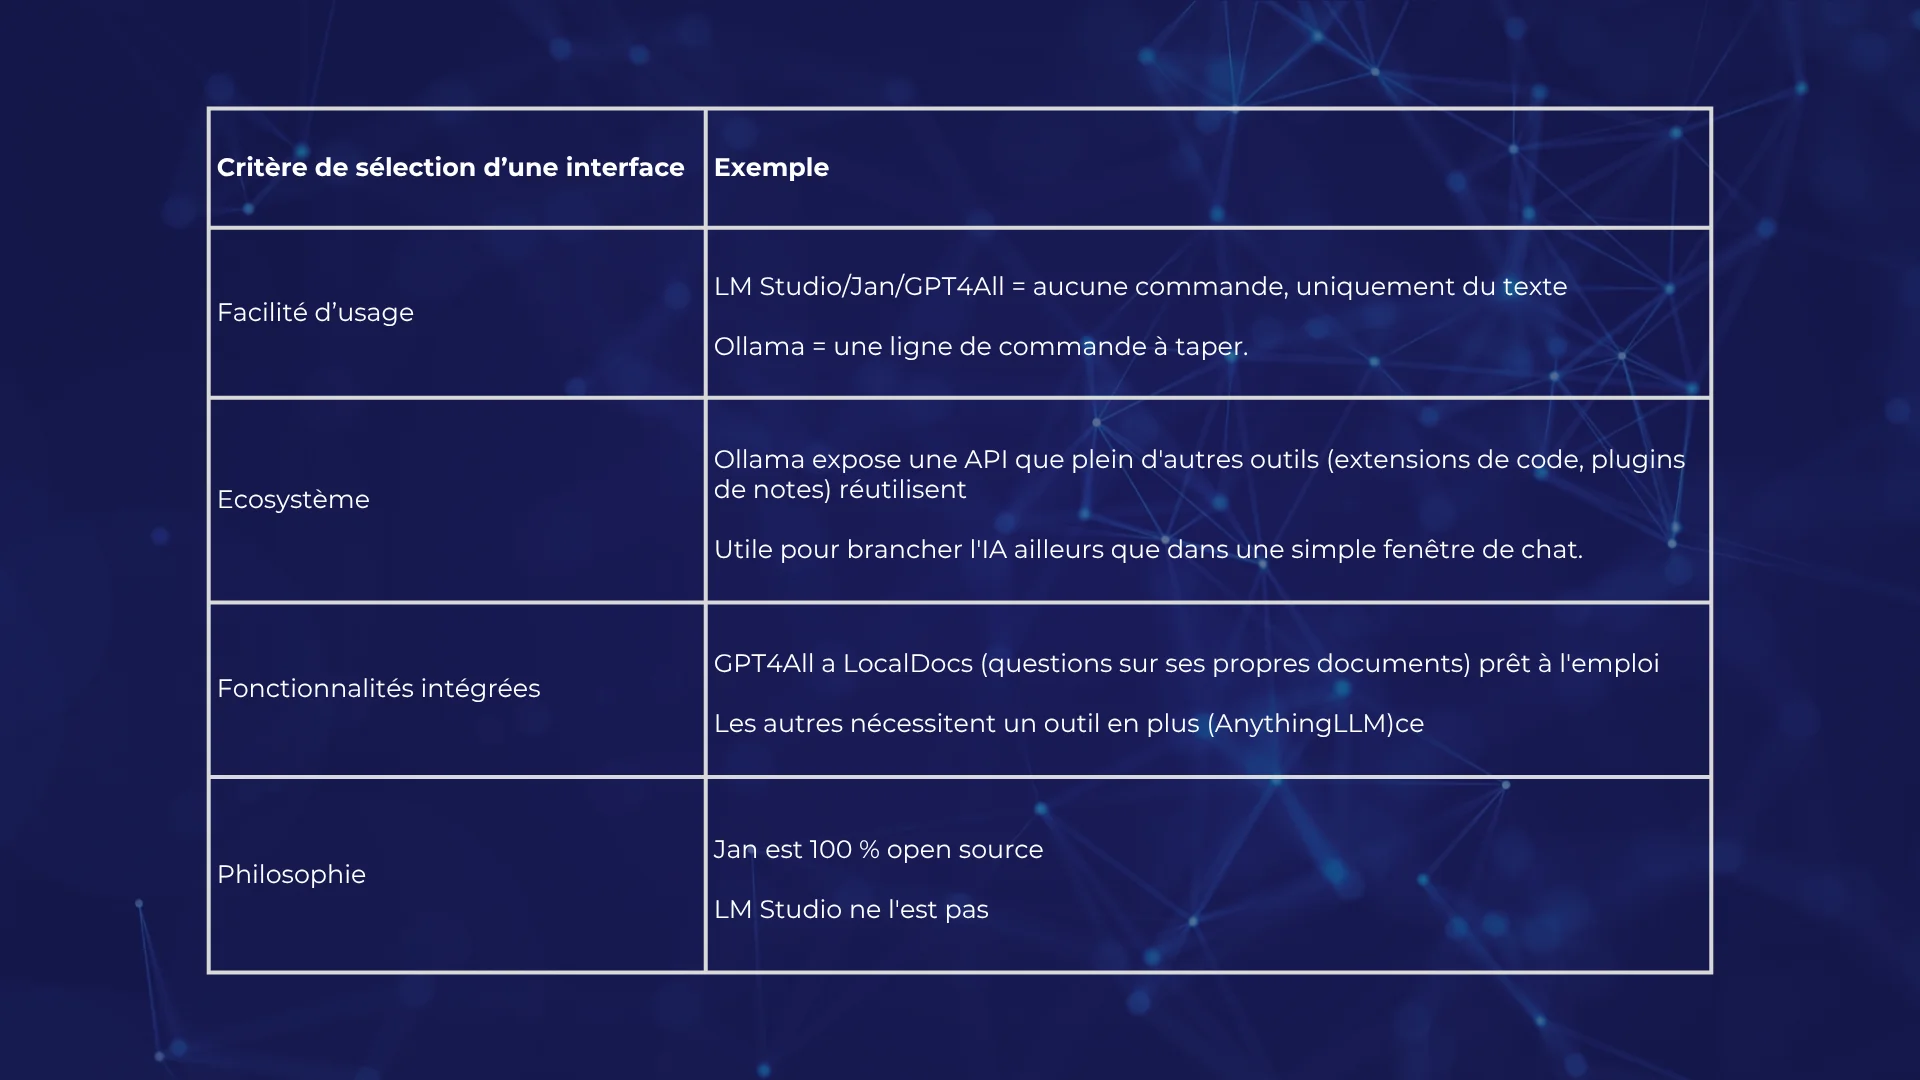
- LM Studio est le point d’entrée le plus confortable pour la plupart des utilisateurs ;
- Ollama est moins immédiat, mais sert de base à de nombreux outils et extensions ;
- Jan propose une interface entièrement open source ;
- GPT4All permet d’interroger ses propres fichiers sans installer d’outil supplémentaire.
Le choix du modèle
Le modèle doit être choisi selon l’usage et le matériel disponible.
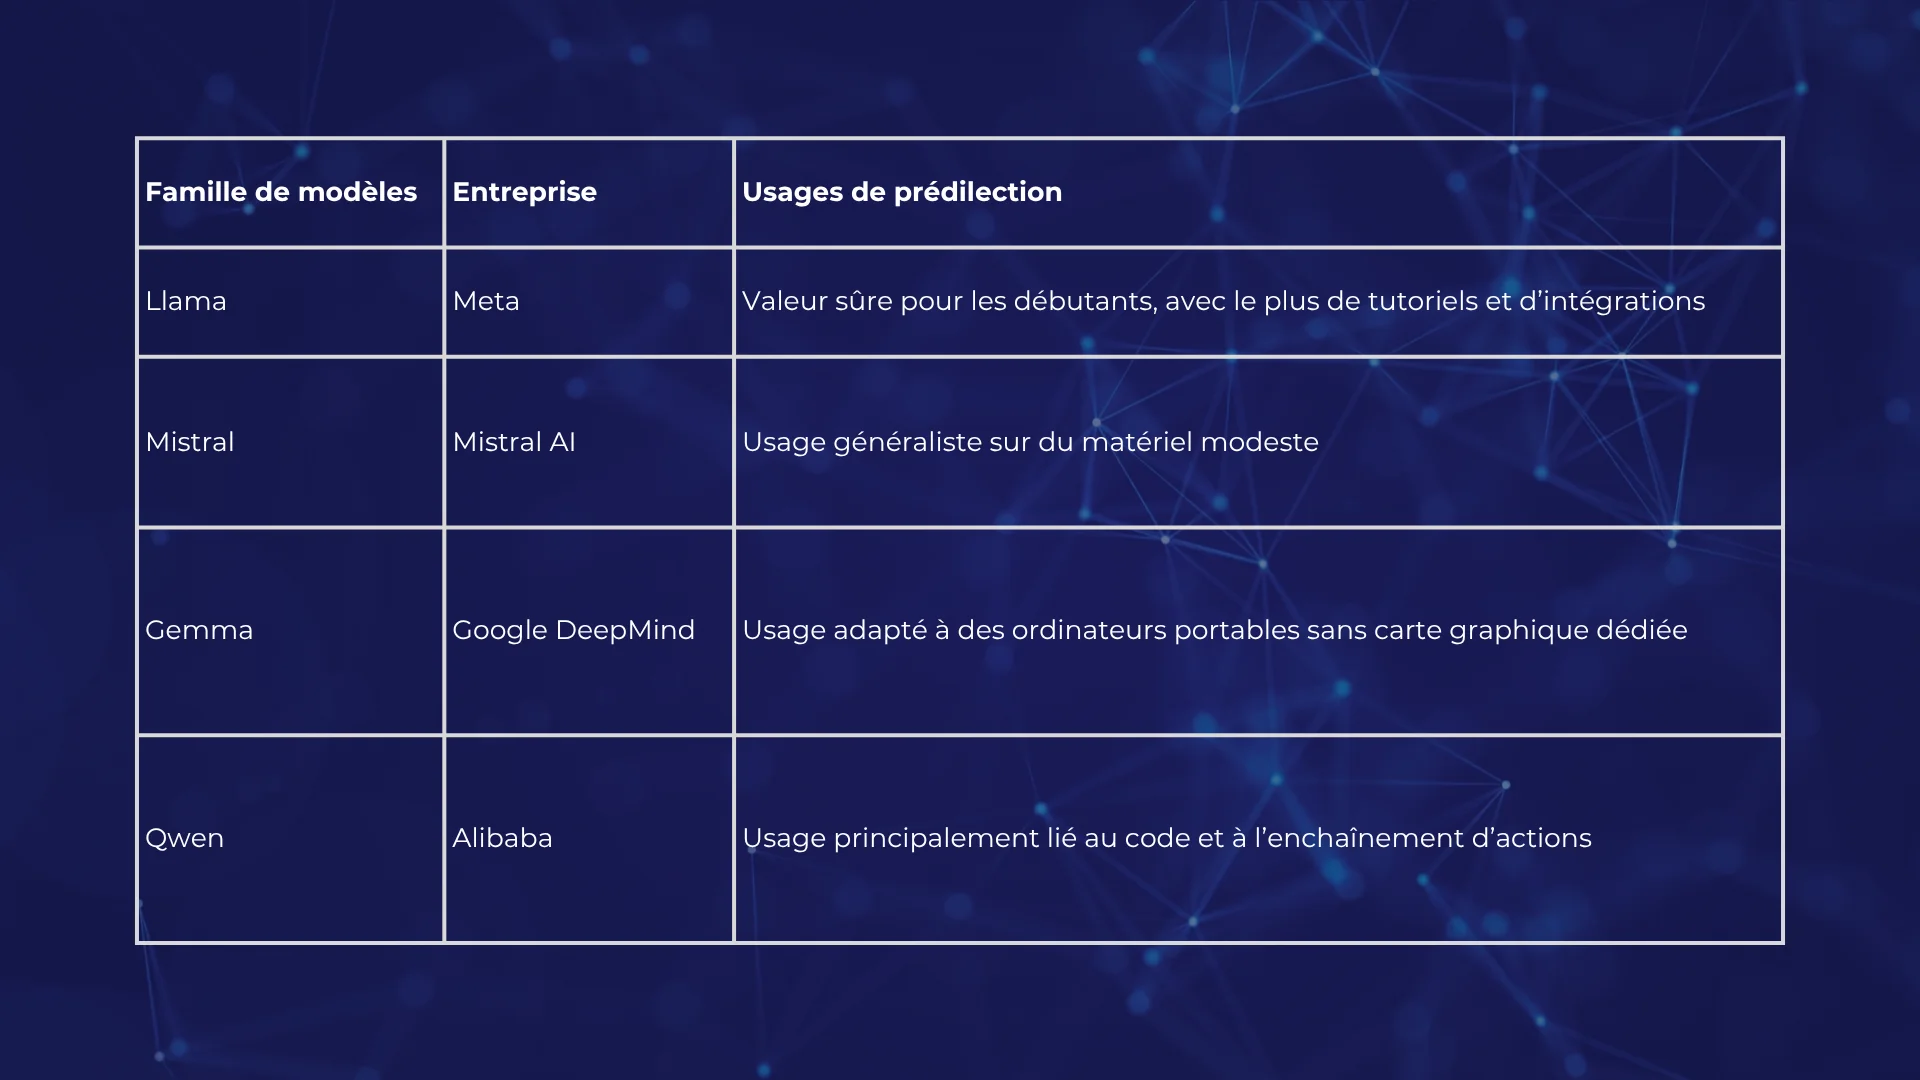
Les versions changent vite : plutôt que de retenir un nom précis, il faut chercher une famille de modèles dans l’interface et prendre la version la plus récente proposée.
Trois informations se retrouvent dans leur nom : la famille, le nombre de paramètres en milliards — la taille du modèle — et la quantisation. Une quantisation Q4 est le compromis le plus utilisé pour réduire fortement la taille tout en préservant l’essentiel des performances.
Exemples de setup
- PC portable léger, 8 à 16 Go de RAM : LM Studio avec une petite déclinaison de Gemma, en Q4.
- PC gamer ou de bureau avec carte graphique dédiée : Mistral Small ou GPT-OSS dans une taille intermédiaire.
- Documents professionnels confidentiels : Ollama ou LM Studio, avec AnythingLLM pour interroger contrats, dossiers ou notes sans que les données ne quittent la machine.
- Développement : Ollama avec Qwen, pour son intégration dans les éditeurs de code.
Ce qu’on y gagne
Installer une IA sur sa propre machine ne prend qu’une vingtaine de minutes, ne génère aucun coût d’utilisation hors matériel et permet de garder ses données sur l’appareil. Le bénéfice le plus marquant reste l’utilisation de l’IA sans compte, sans conditions d’utilisation à accepter et sans dépendre d’un serveur distant.